WordStarアーカイブからプレーンテキストを抽出する
言葉が必要なとき―それ以外は何もいらない。
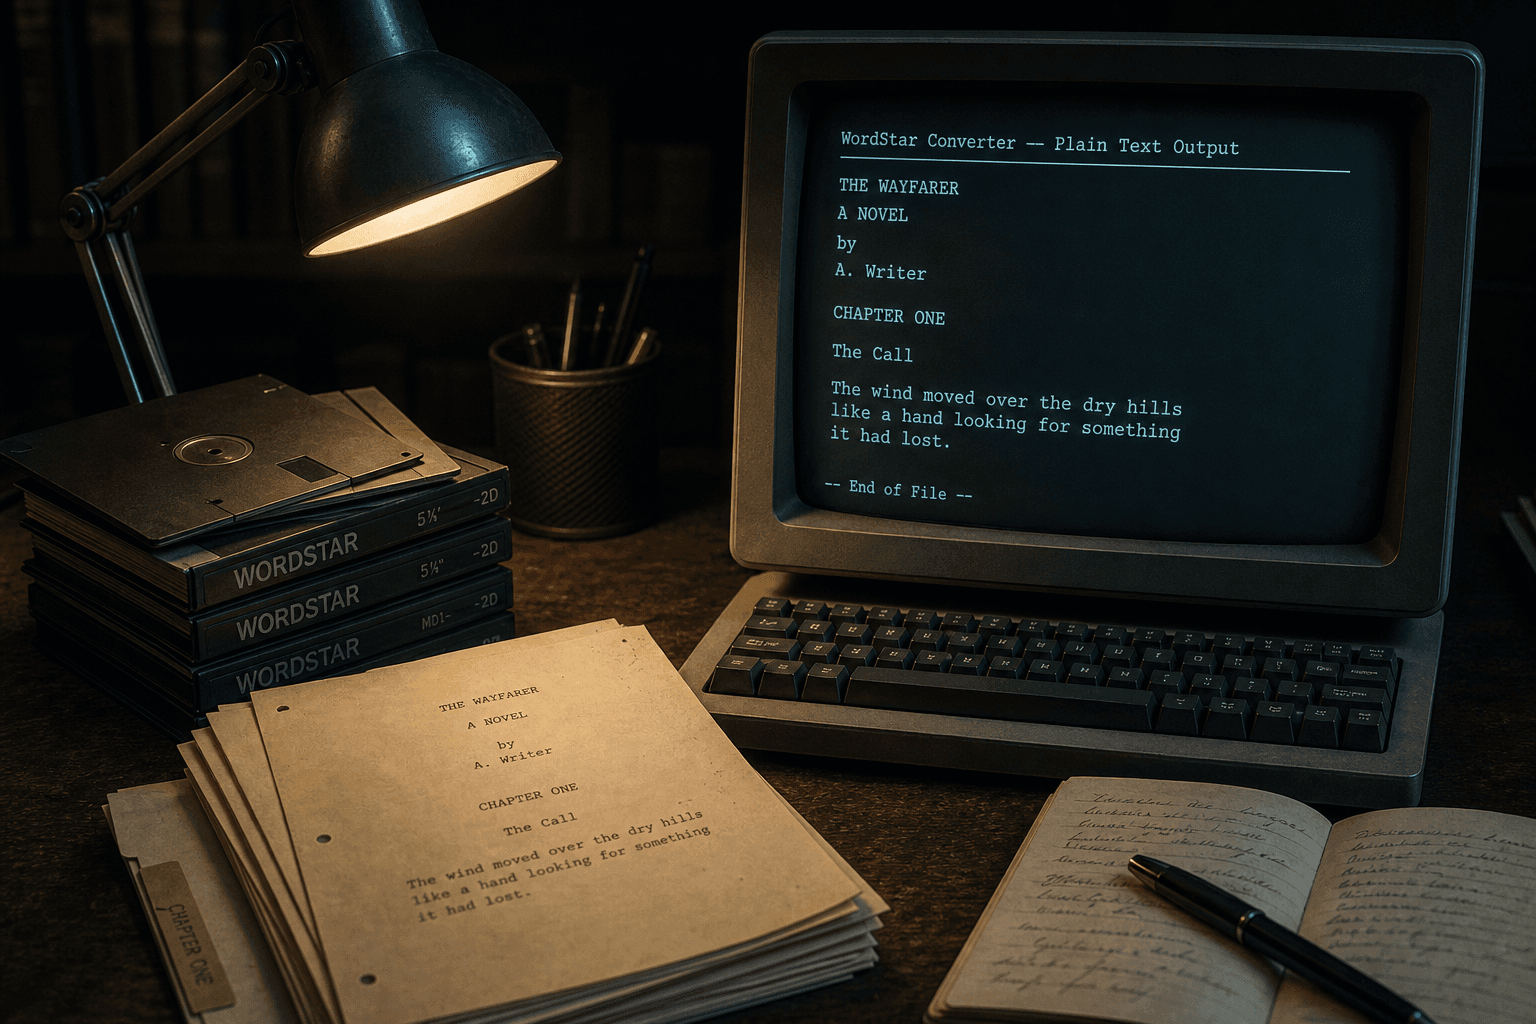
TL;DR
TXT は読めない WordStar ツリーを回答可能にします。WordStar Converter は高ビットフラグをローカルで UTF-8 テキストに展開します。試用は __TRIAL_FILE_LIMIT__ ファイルまで。Standard __LICENSE_PRICE_DISPLAY__。
なぜ単純なダンプが失敗するのか
Notepadで`.ws`ファイルを開くことは「プレーンテキストの抽出」ではありません。多くの文字のビット7はラップフラグです。拡張グリフは`1Bh xx 1Ch`のトリプレットとして現れます。アンラップのステップがなければ、grepはあなたに嘘をつきます。
クリーンTXTは何のためですか
トリアージ:DOCX/PDFの予算をツリー全体に使う前に、どの文書が条項、名前、または訴訟番号を言及しているかを見つける。スクリプト:UTF-8を内部抽出器に入力する。検索:マスターの横に`.txt`の兄弟を配置してWindows Searchまたはripgrepを使用する。
ワークフロー
まずアーカイブをTXTにバッチ処理し、ホットセットを特定してから、それらのパスをDOCXまたはPDFに再変換します。ネイティブのパーサー1つ、パス2回 — それでもオフラインです。
試用 __TRIAL_FILE_LIMIT__ ファイル。Standard __LICENSE_PRICE_DISPLAY__。
TXT vs Markdown
構造が重要でない場合はTXTを使用してください。見出しや強調がドキュメントやRAGで保持されるべき場合はMarkdownを使用してください。どちらの方法でも原稿はアップロードされません。
関連記事
アーカイブを検索可能にする
試用 __TRIAL_FILE_LIMIT__ ファイル。Standard __LICENSE_PRICE_DISPLAY__。
無料トライアル
アプリ全機能 — 最大 10 ファイル
Windows 10 または 11
完全な 10 ファイルトライアル用の Windows インストーラーをダウンロード。ライセンスで解除するのと同じアプリ — PC 上で 100% ローカル。